产品介绍
更新时间:2026-10-09 01:08:17
视觉大模型介绍
以图形训练的大模型为核心,对视频、图片中的各类事件进行自动识别,覆盖公路养护、施工安全、消防应急、城市治理、园区管理等场景,实现事件的自动发现、预警与处置闭环管理。
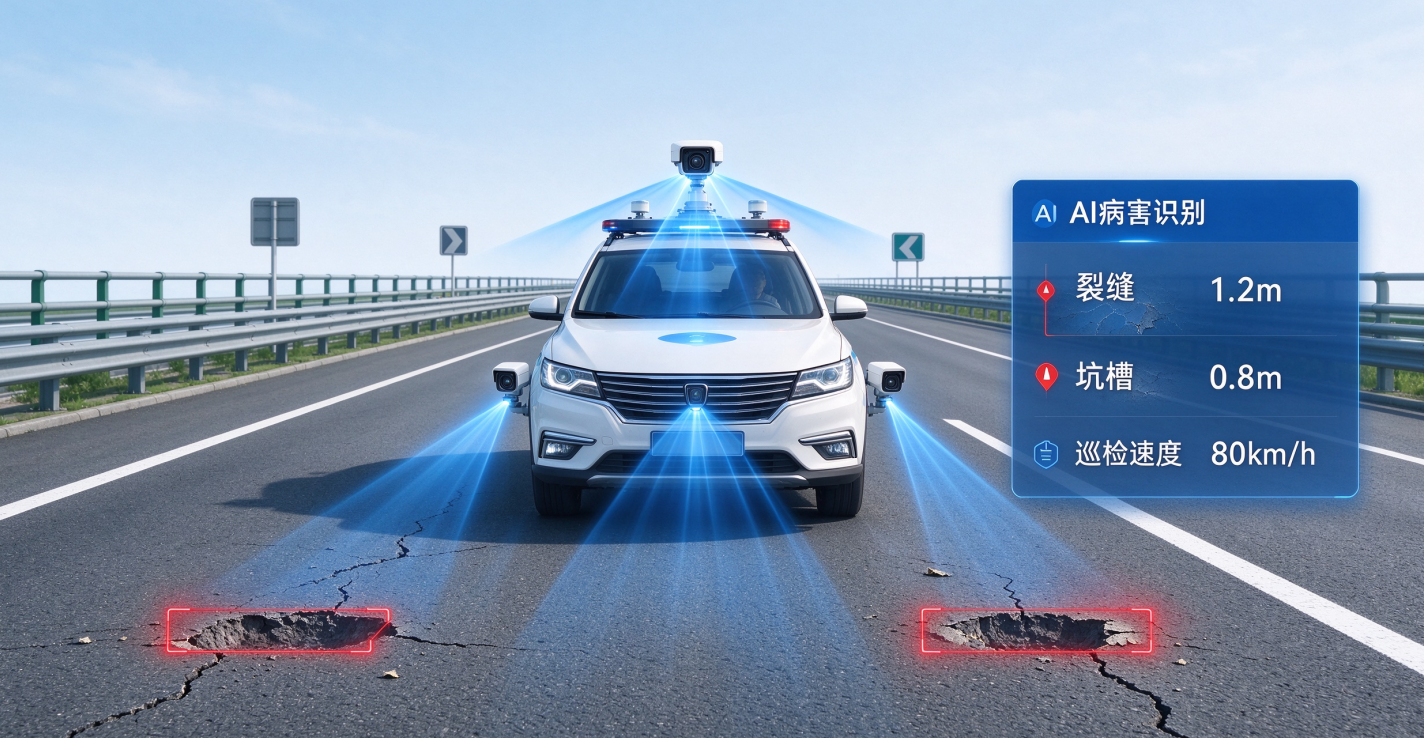
视觉大模型是基于深度学习与海量图像、视频数据训练的人工智能模型,能够对监控视频与图片中的目标、行为进行自动识别,可识别公路病害(裂缝、坑槽、护栏缺损等)、建筑工地未戴安全帽、起火冒烟、垃圾堆放、车辆违停违摆、人员打瞌睡等各类事件。系统以视觉大模型为技术底座,摄像头采集画面后由模型自动分析识别,发现事件即时生成告警;管理人员通过平台实时查看事件并派发处置工单;处置结果自动回填复核,形成“识别—预警—处置—复核”的闭环管理。
1、适用对象:公路养护、建筑施工、消防应急、城市管理、园区物业、仓储物流等需要视频智能监管的单位
2、部署方式:云端API调用/本地私有化部署/边缘盒子部署
3、能力支持:公路病害识别、安全帽检测、烟火识别、垃圾堆放识别、违停违摆识别、打瞌睡检测等
传统模式下的六大痛点:
1、人工监看:盯屏疲劳,漏看漏报
2、公路养护:病害发现晚,巡查成本高
3、施工安全:违章行为难监管
4、城市治理:违规事件发现难
5、园区与办公:行为风险难预警
6、系统与运营:能力孤岛,建设成本高
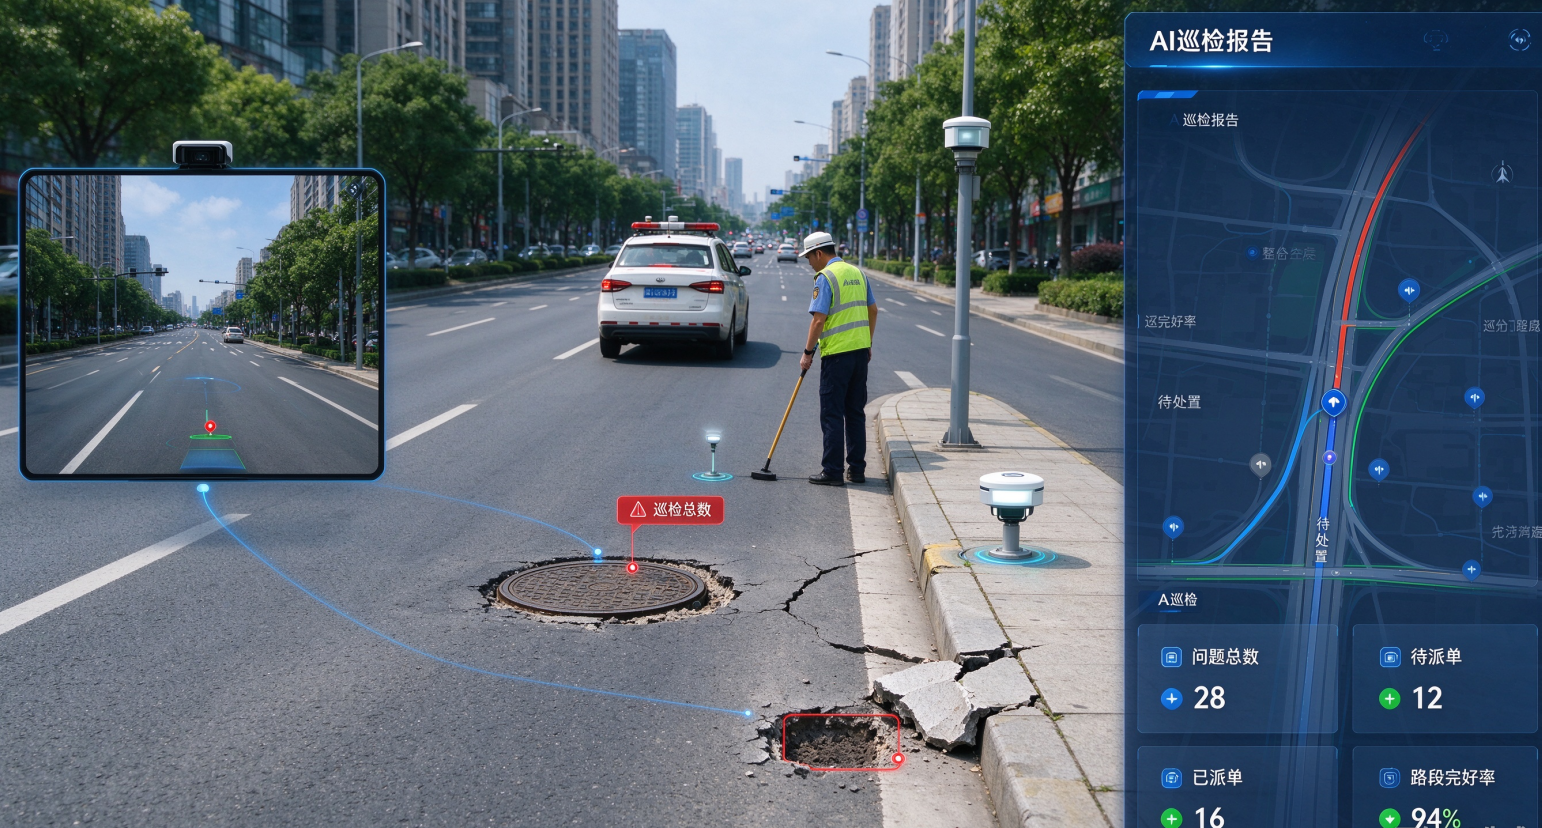
视觉大模型以“识别即告警、告警即处置”的方式,把公路病害、未戴安全帽、烟火、垃圾堆放、违停违摆、打瞌睡等事件的自动识别能力赋予各行业,替代人工盯屏、人工巡查、事后查录像模式,价值分为效率提升、安全提升、成本优化三大维度:
1、对一线巡查与监管人员价值:自动识别代替人工盯屏与上路巡查,事件发现即告警,工作强度大幅降低,处置有的放矢。
2、对业务管理人员价值:事件自动派单、处置线上闭环、过程留痕可追溯,监管覆盖全天候,考核有据可依。
3、对单位领导价值:通过看板实时查看事件发现、处置与整改情况,不受时间、空间限制,掌握全域真实情况,实现信息对称。